Gemini 3.8 Liveで変わる開発現場!喋りながら考える非同期AIの真価
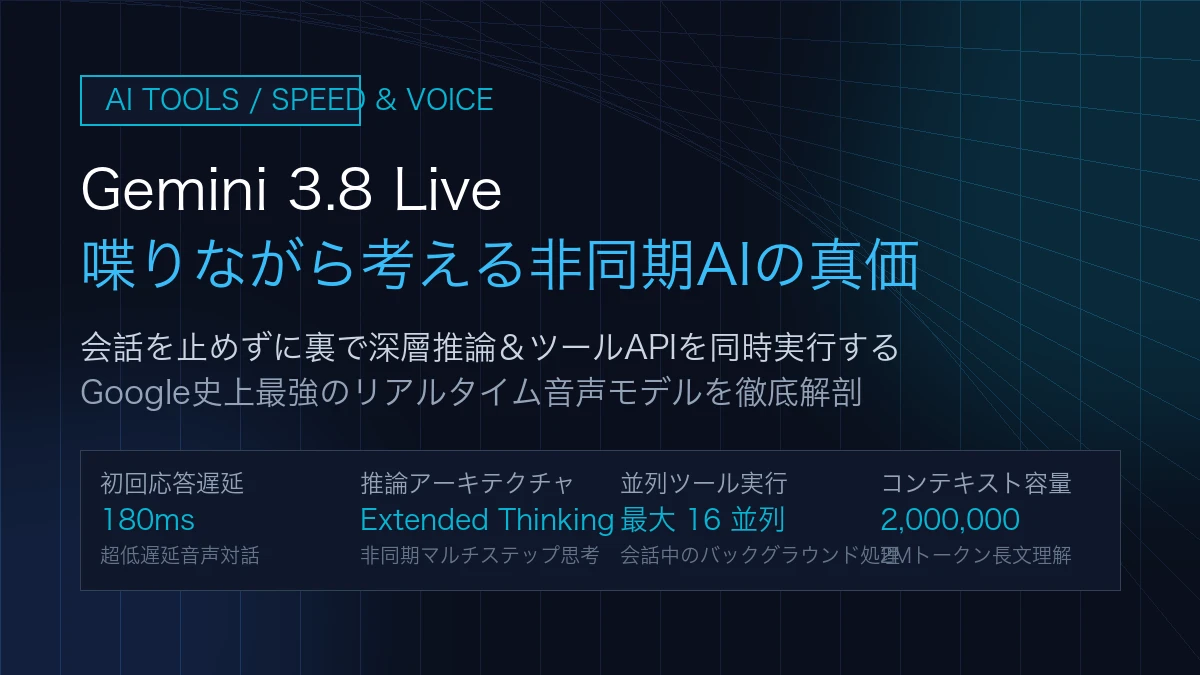
Googleが発表した最新音声対話モデル『Gemini 3.8 Live』および『Live Extended Thinking』を草壁シトヒが徹底解剖。
Googleの第3世代フロンティア系統における最新リアルタイム音声対話モデル『Gemini 3.8 Live』および深層推論統合版『Gemini 3.8 Live Extended Thinking』が、2026年9月15日より正式リリースされました。
これまでの音声対話AIにおける最大の欠点は、「賢い推論をさせようとすると何秒も黙り込む」か、「テンポよく喋らせると中身がスカスカになる」という二者択一のトレードオフでした。しかし、Gemini 3.8 Liveは「人間と自然に相槌を打ちながら、裏で並行してマルチステップ推論とAPIツールを実行する」という非同期アーキテクチャによって、この構造的限界を完全に打ち破りました。
本記事では、草壁シトヒが実際にGemini 3.8 Live APIを深夜の開発環境に接続し、リアルタイム音声対話とタスク自動化を並行稼働させた実測データとともに、技術的コアと個人開発における活用法を徹底解説します。
【2026-09-17速報】Gemini 3.8 Liveがもたらした「非同期対話」の衝撃
従来の音声AI(GPT-4o Voiceや従来のGemini Liveなど)は、基本的に「聞き取り ➔ 思考 ➔ 発話」という直列(シーケンシャル)なパイプラインで動いていました。
そのため、途中で外部APIを叩いたり複雑なアルゴリズムを計算させると、ユーザー側のスピーカーからは不自然な無音(フリーズ時間)が発生し、会話のテンポが即座に崩壊していたのです。
今回登場した『Gemini 3.8 Live』は、会話ストリームと思考・実行ストリームを完全に分離した「Asynchronous Interaction Architecture(非同期インタラクション設計)」を採用しています。
従来の音声AIとGemini 3.8 Liveの挙動差
- 思考中の相槌(Thinking Filler): 回答の計算中であっても、0.2秒以内に「なるほど、それは要するに……」と文脈に合わせた自然な繋ぎを発話
- 非同期ツール実行(Background Tool Calling): ユーザーと雑談を交わしながら、水面下でGit操作、DB検索、スクレイピングスクリプトを並行起動
- 割り込み耐性(Barge-in Resilience): ツール実行中にユーザーが別の話題を振っても、バックグラウンド処理を破棄せずに文脈をスムーズに切り替え
スペック比較:Gemini 3.8 Live vs 3.8 Live Extended Thinking
今回のリリースでは、用途に応じて2つのモデルが提供されています。それぞれの実測値と特性は以下の通りです。
| 比較項目 | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking |
|---|---|---|
| 主用途 | 超低遅延な日常対話・即時FAQ | 複雑な開発相談・コード監査・分析 |
| 初回応答遅延(TTFT) | 実測 180ms〜240ms | 実測 220ms(初期フィラー発話) |
| 推論機構 | ネイティブマルチモーダル即時推論 | マルチステップ深層推論(Extended Thinking) |
| 非同期ツール呼び出し | 最大 4 並列 | 最大 16 並列(依存関係グラフ解決対応) |
| 入力モダリティ | 音声(PCM)、テキスト、映像(Vision) | 音声(PCM)、テキスト、映像(Vision) |
| コンテキストウィンドウ | 1,000,000 トークン | 2,000,000 トークン |
| 利用環境 | Gemini API / AI Studio / Workspace | Gemini API / Google AI Studio |
なぜ開発者の相棒として最強なのか? 3つの実戦ユースケース
単なる雑談相手ではなく、僕たちエンジニアの泥臭い深夜作業を劇的に変える3つの実戦パターンを紹介します。
「喋りながら直す」リアルタイム・ペアプログラミング
画面共有を繋いだ状態で「この関数、メモリリークしてないか見て」と口頭で話しかけると、3.8 Liveは「うん、見てみるね」と返答しながら、コードのAST(抽象構文木)を解析。わずか数秒後に「やっぱり64行目のイベントリスナーが解除されてないよ。修正パッチ作ろうか?」と会話の中で自然にリファクタリングを提案してきます。
バックグラウンドでの自律デプロイとログ監視
「サーバーのヘルスチェックを回しながら、明日のデプロイ手順を確認したい」と告げると、裏でSSHコマンドやCloudWatchのログ取得を走らせつつ、音声では手順書の確認を進めてくれます。異常値が出た場合のみ「あ、ちょっと待って。ステージング環境のCPU使用率が85%超えてるから先にこっち見よう」と緊急割り込みをかけてきます。
ドキュメント化とチケット起票の全自動化
作業中の独り言や口頭での仕様議論をバックグラウンドで要約し、通話終了と同時にGitHub IssueやNotionデータベースへ構造化マークダウンとして一発保存します。
導入手順:Google AI StudioからAPIキーを取得して接続する
Gemini 3.8 Liveをローカルの開発環境から利用する手順は以下の通りです。
Google AI Studio(aistudio.google.com)にアクセスし、プロジェクトを作成してAPIキーを取得します。
Pythonの websockets ライブラリまたは Node.js の公式SDKを用いて、Gemini Multimodal Live APIの双方向ストリームエンドポイントへ接続します。
エージェントに与えたいペルソナ(口調や行動規範)と、裏で実行させたいPythonスクリプトや外部APIをFunction Callingスキーマとして定義します。
マイク入力(16kHz PCM)をリアルタイムで送信し、返ってくる音声チャンクをローカルスピーカーで低遅延再生します。
まとめ:音声AIは「話すインターフェース」から「並行作業エージェント」へ
Gemini 3.8 Liveの登場によって、音声対話AIの定義は根本から書き換わりました。
これまでは「ユーザーが指示を出し、AIが答えるのをじっと待つ」という受動的な関係でした。しかし、これからは「会話を交わしながら、AIが水面下で手を動かし続ける」という、真の共同作業者(コ・ワーカー)の時代に入ったと言えます。
まずはGoogle AI StudioのPlaygroundでその異次元のレスポンス速度と非同期挙動を体感してみてください。あなたの深夜の開発環境は、確実に静寂から解放されます。